Gerador de Imagem com IA
Imagem para Imagem
Transforme uma imagem de referência em uma nova imagem com IA: escolha qualquer modelo compatível.
O que você pode criar
Prompts reais e seus resultados dos modelos disponíveis aqui.
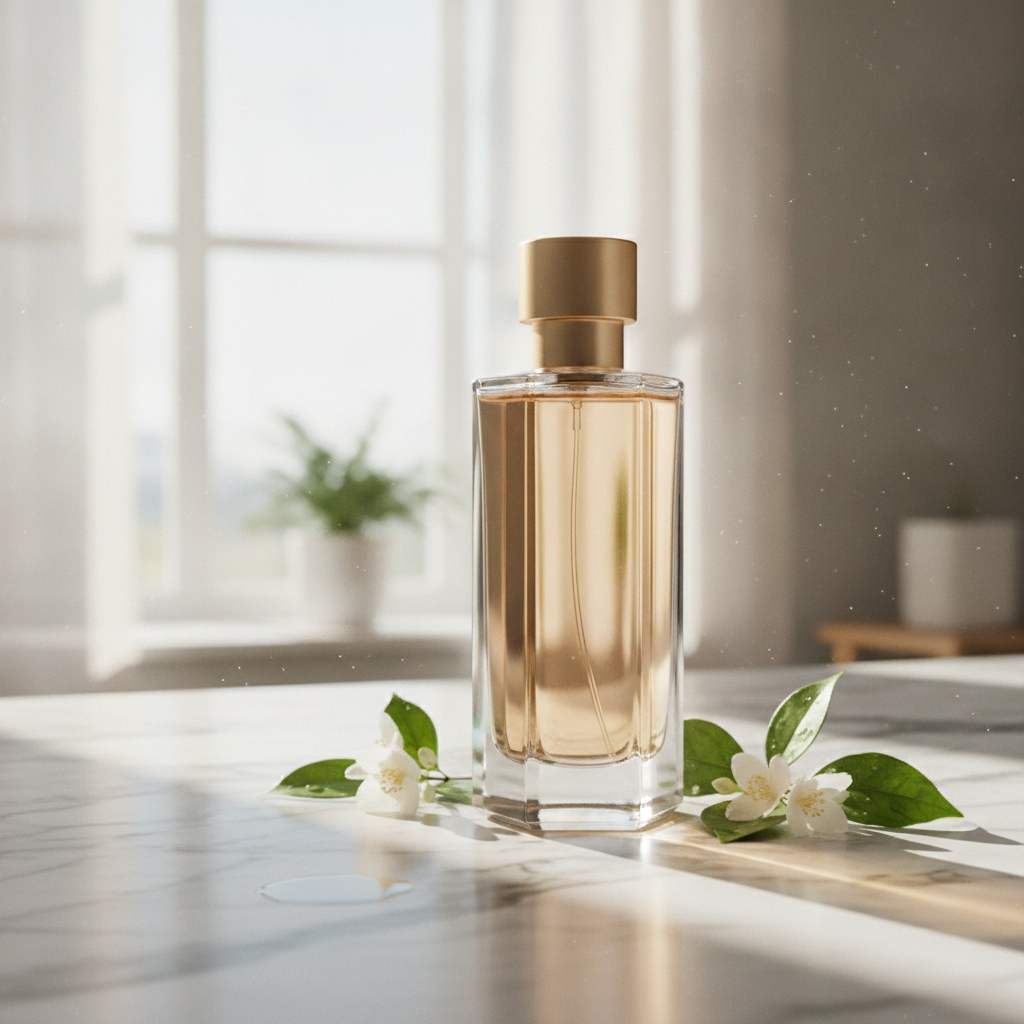
A sleek perfume bottle from a studio shot placed on a sunlit marble countertop with soft morning light, composited as one natural scene

E-commerce hero photograph of a stand-up kraft paper coffee bag with a matte cream label, square format, on a seamless warm beige background with a few roasted coffee beans scattered in front. The label text is large, crisp and spelled exactly: NORTH RIDGE in a bold black serif across the top, COFFEE ROASTERS in small spaced capitals under it, ETHIOPIA GUJI in medium black capitals in the middle, Washed · Light Roast on the next line, Peach · Jasmine · Honey on the line below, and 250 g at the bottom right of the label. Soft window light from the left, a gentle shadow, realistic paper texture and printing. No other text, no logos.

Photoreal interior of a small Japanese tea house at dawn during light rain, square format: tatami with visible weave, a low black lacquer table with a single ceramic cup and a thread of steam, shoji screens glowing with grey morning light, wet dark stepping stones and a bamboo ladle in the garden seen through the open engawa, a blank hanging scroll on the wall. Directional light from the screens on the left, soft shadows, fine wood grain on every post, precise texture at every scale from the cup to the garden. 50mm lens look, deep focus. No people, no text, no watermark.
Modelos para Imagem para Imagem
20 modelos suportam este tipo de tarefa. Abra qualquer um para ver as especificações completas.
O Wan 2.7 da Alibaba cria o quadro e depois o põe em movimento: imagens, edições e clipes com som de uma só família de modelos.
O Flux 3 pequeno e rápido: uma imagem a partir de um prompt, ou uma única mudança sobre até dez referências.
O novo modelo de imagem Flash do Google: as palavras voltam escritas certo, e o rosto aguenta a próxima edição.
Duas velocidades na mesma página, e as palavras que você digitou voltam escritas certo.
O modelo de imagem da Meta revisa o próprio rascunho antes de devolver a imagem.
A cara do Midjourney que você já conhece, com títulos que enfim se leem.
Crie imagem com IA usando o Grok Imagine Image 2.0: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
A versão de maior detalhe do Qwen Image 3.0 para geração refinada e edições fiéis à origem.
Um único modelo para escrever uma imagem nova a partir de texto e revisar uma existente com uma instrução direta.
A versão leve do Nano Banana do Google: imagens 1K e edições rápidas para produzir em volume.
Crie imagem com IA usando o Nano Banana 2: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o Nano Banana Pro: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o Seedream 5.0 Lite: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o GPT Image 2.0: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o Midjourney V7: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o Nano Banana: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o Seedream 4.5: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o Flux Kontext: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o GPT Image 1.5: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Crie imagem com IA usando o Seedream 4.0: texto para imagem e imagem para imagem, tudo em um só espaço na Vidney.
Como usar o Imagem para Imagem da Vidney
Crie imagem com IA usando o Imagem para Imagem da Vidney em três passos.
Perguntas frequentes
O que é o Imagem para Imagem da Vidney?
O Imagem para Imagem da Vidney deixa você criar imagem com IA a partir de imagem para imagem usando qualquer modelo compatível em um só espaço.
Quais modelos posso usar com o Imagem para Imagem?
Você pode usar Wan 2.7, Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, Muse Image, Midjourney V8.1, Grok Imagine Image 2.0, Qwen Image 3.0 Pro, Qwen Image 3.0, Nano Banana 2 Lite, Nano Banana 2, Nano Banana Pro, Seedream 5.0 Lite, GPT Image 2.0, Midjourney V7, Nano Banana, Seedream 4.5, Flux Kontext, GPT Image 1.5 e Seedream 4.0.
Preciso de chave de API para usar o Imagem para Imagem?
Não. A Vidney cuida do acesso ao provedor e da cobrança; não há chaves de API para gerenciar nem conta de provedor para configurar.