Vidney

Générateur d'image IA

GPT Image 2.5

Deux vitesses sur une même page, et les mots que vous tapez reviennent bien orthographiés.

Espace de travail Vidney

21 modèles
0/2000
Requis : 3 crédits

Résultat

Exemple

GPT Image 2.5 : Flare ou Sunburst ?

GPT Image 2.5 existe en deux versions, et cette page propose les deux au même prix. Ce qui les distingue, c’est la vitesse face à la précision.

OpenAI livre GPT Image 2.5 sous forme de deux variantes derrière une seule interface. Ce qu’OpenAI met en avant pour cette génération, le texte entre guillemets rendu tel qu’il a été saisi et les retouches qui ne touchent que l’élément nommé, les deux variantes le font aussi bien, et un prompt chargé peut demander un second passage sur l’une comme sur l’autre. Flare est celle qu’OpenAI désigne comme choix par défaut pour la plupart des usages : elle produit une image en environ la moitié du temps qu’il fallait à GPT Image 2. Sunburst place la précision en premier : elle préserve plus fidèlement les détails complexes et met plus de temps à terminer. Sur Vidney, les deux acceptent les mêmes prompts, jusqu’à quatre images de référence, les mêmes cinq formats et les mêmes tailles 1K, 2K et 4K, et coûtent les mêmes crédits à chaque taille. Le choix ne touche jamais votre solde, seulement le chronomètre et le résultat.

La rapide

Flare

C’est par Flare que la plupart des travaux devraient commencer. Ce que Flare ajoute, c’est la vitesse : elle revient assez vite pour itérer sur une mise en page plutôt que de l’attendre, et dans nos propres essais une image 4K s’est achevée en 47 secondes. Le lettrage net et les retouches cadrées qui font la réputation de cette génération sont bien là, simplement plus vite.

À choisir pour

  • Premiers jets et exploration de pistes
  • Des séries de variantes sur un même brief
  • Des écrans et des affiches qui passeront par plusieurs révisions

La précise

Sunburst

Sunburst est la plus précise des deux pour la retouche, faite pour l’image où rien ne doit bouger. Nommez un élément et le reste de l’image est censé rester en place ; en 4K, les détails fins comme les petits caractères restent lisibles quand on zoome. Ce soin se paie en temps : la même image 4K que Flare a terminée en 47 secondes a demandé 64 secondes à Sunburst.

À choisir pour

  • Les retouches où seule la partie nommée peut changer
  • Une gamme de produits qui doit rester fidèle à une prise validée
  • Les travaux 4K destinés à être vus en grand ou imprimés

Commencez sur Flare, puis passez à Sunburst dès qu’une retouche doit tenir ou qu’un détail doit supporter un regard rapproché. Les deux figurent dans le menu des modèles du générateur ci-dessus, sous les noms GPT Image 2.5 Flare et GPT Image 2.5 Sunburst, aux mêmes crédits.

Ce que GPT Image 2.5 réussit

01

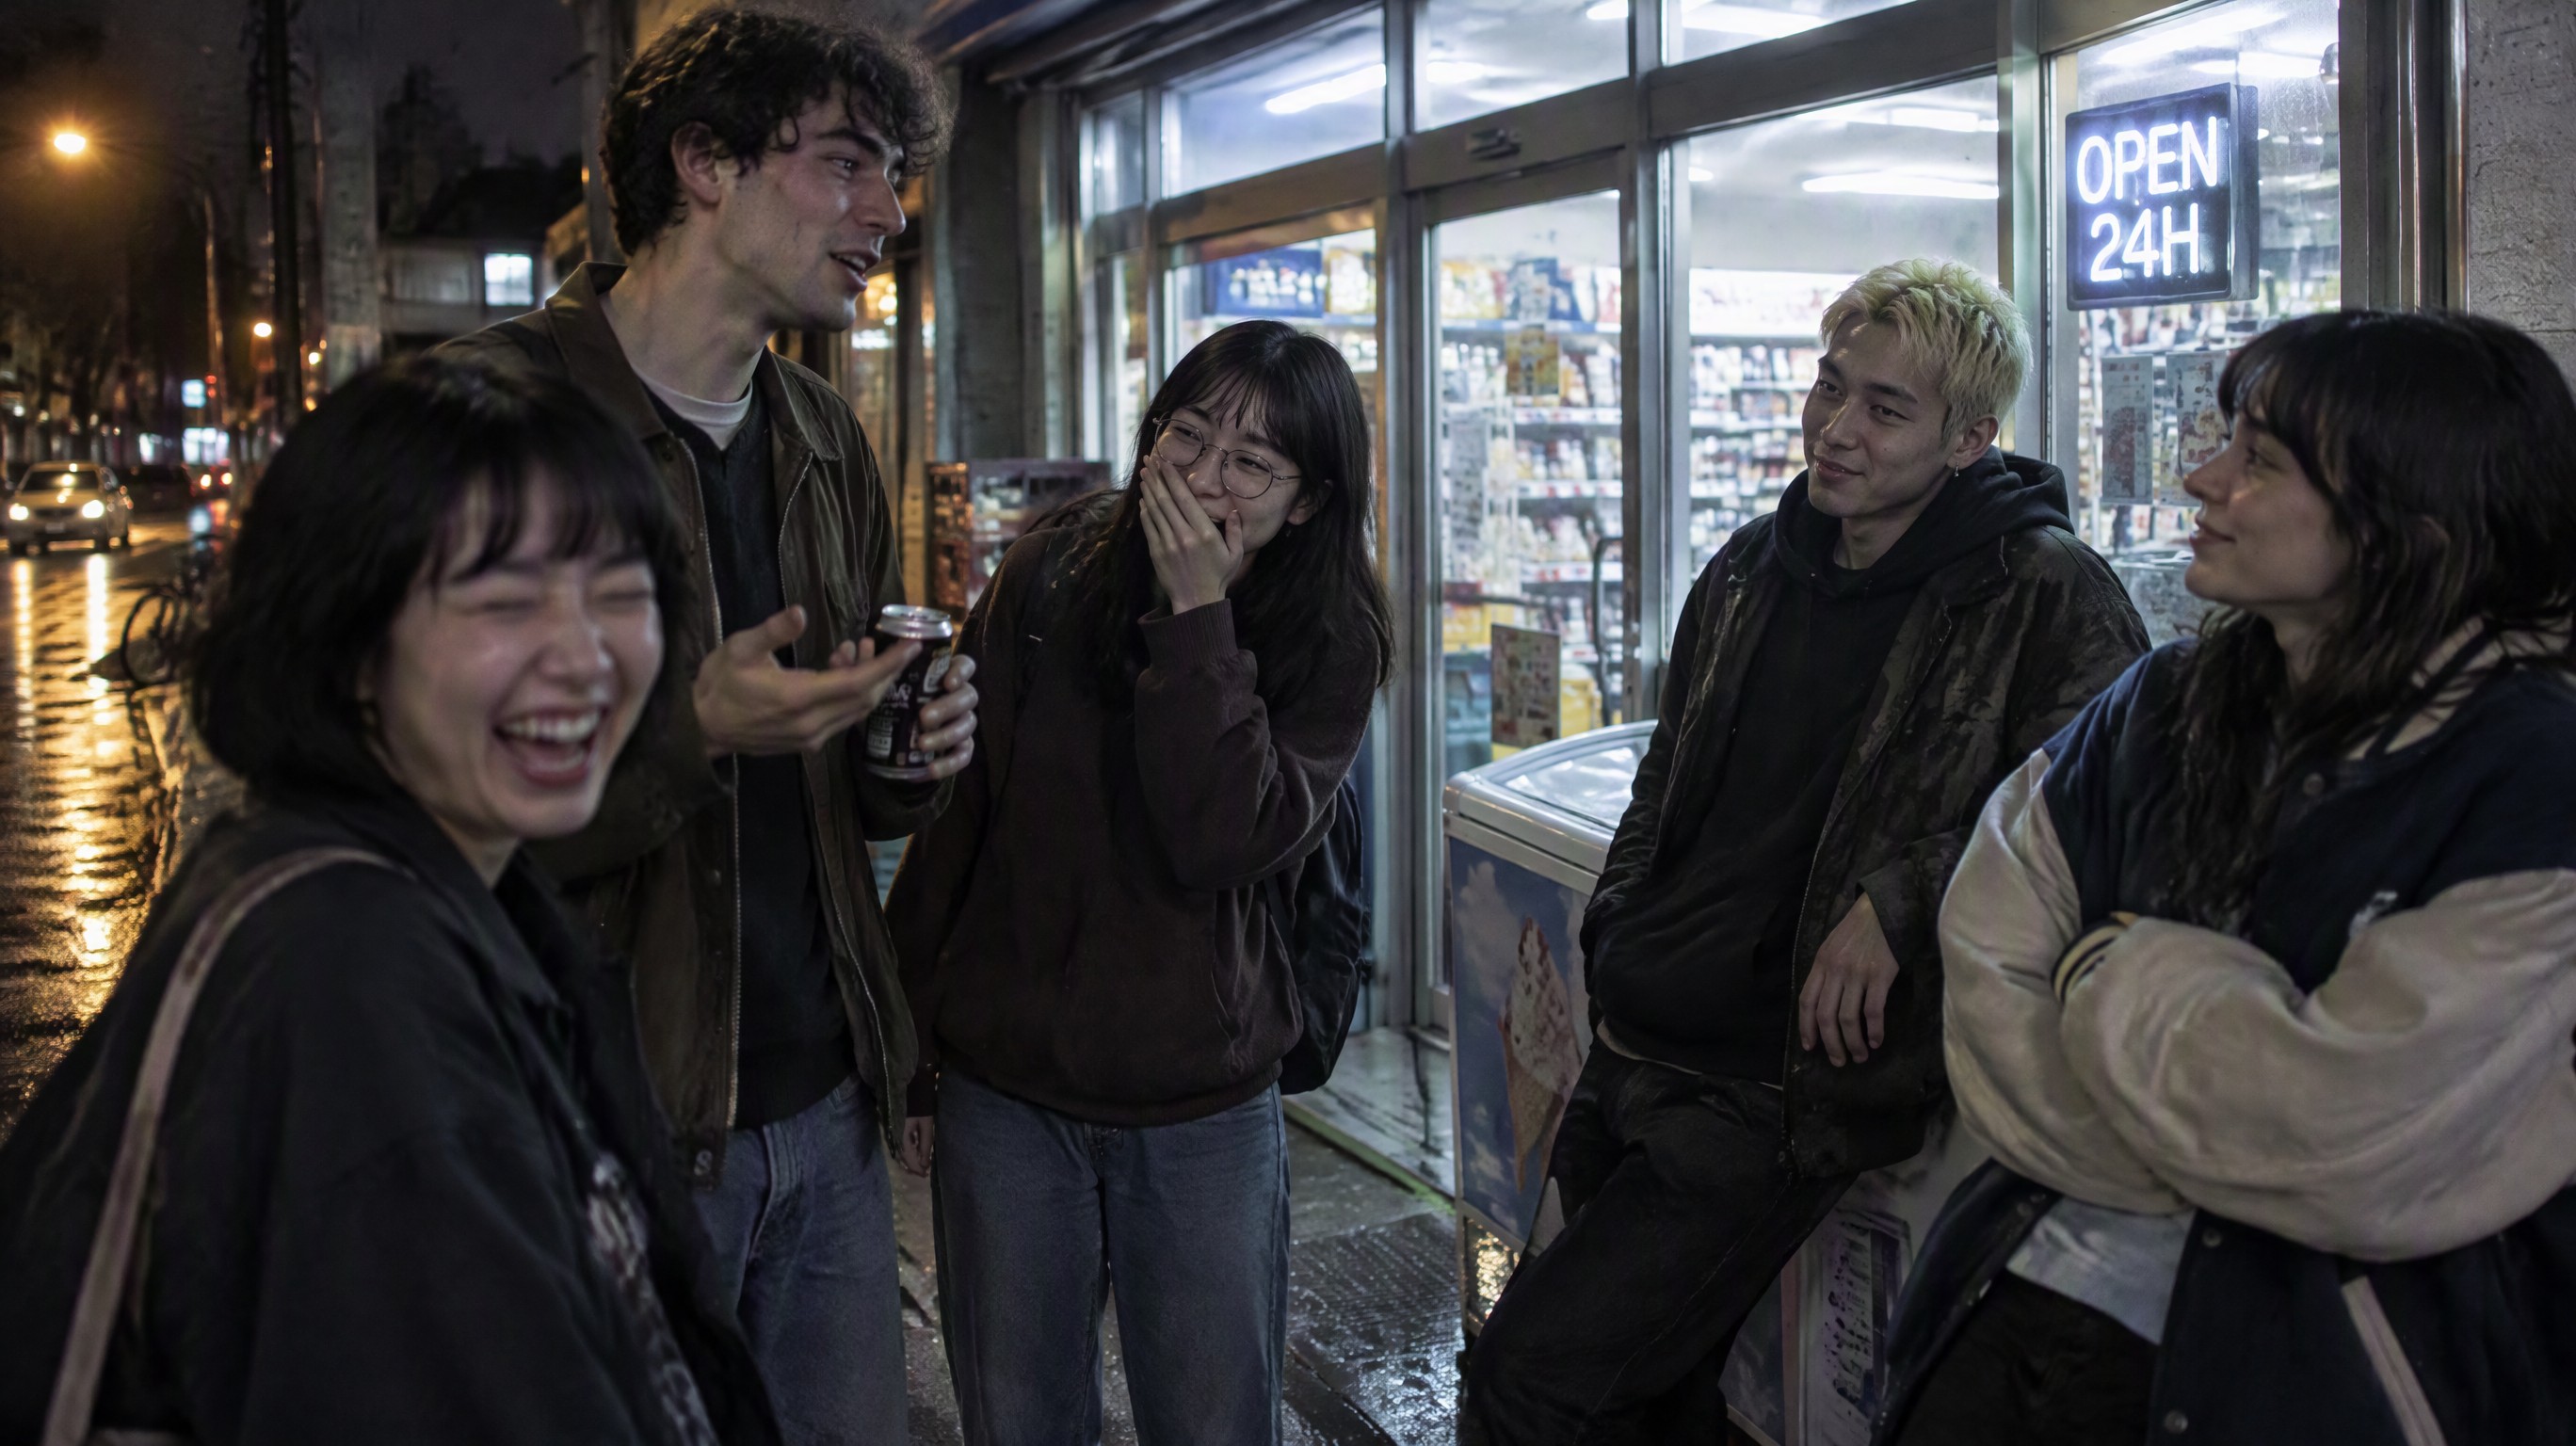
Cinq visages, aucun ne se ressemble

Cinq amis devant une épicerie de nuit après minuit, éclairés seulement par la vitrine et un lampadaire. Chaque visage est une personne à part, un rire différent, un regard différent, une vraie peau sous la lumière crue des néons, et personne ne pose pour l’appareil.

Cinq visages, aucun ne se ressemble: Photorealistic candid photograph of five friends in their early twenties hanging out on the sidewalk in front of a small 24-hour convenience store late at night, laughing and talking in the middle of a story. Each face is clearly different and clearly lit: a young woman with a short black bob laughing with her eyes squeezed shut, a tall young man mid-sentence gesturing with a canned coffee, a young woman in round glasses covering her grin with one hand, a young man with bleached hair leaning against the ice-cream freezer by the door with a lopsided smirk, and a young woman in an oversized varsity jacket looking sideways at her friend with a fond half-smile. Natural mixed lighting only: cool white fluorescent light spilling from the store windows onto the pavement, one warm streetlamp far to the left, soft reflections on slightly damp asphalt. Shot on a 35mm lens at f/2 from a few steps away, the friend nearest the camera slightly out of focus, real skin texture with pores and a little shine, no beauty retouching, nobody posing for the camera. The storefront is generic and unbranded; the only readable text is a small glowing sign reading 'OPEN 24H'. Documentary photography, muted colours, faint film grain.
Prompt

Photorealistic candid photograph of five friends in their early twenties hanging out on the sidewalk in front of a small 24-hour convenience store late at night, laughing and talking in the middle of a story. Each face is clearly different and clearly lit: a young woman with a short black bob laughing with her eyes squeezed shut, a tall young man mid-sentence gesturing with a canned coffee, a young woman in round glasses covering her grin with one hand, a young man with bleached hair leaning against the ice-cream freezer by the door with a lopsided smirk, and a young woman in an oversized varsity jacket looking sideways at her friend with a fond half-smile. Natural mixed lighting only: cool white fluorescent light spilling from the store windows onto the pavement, one warm streetlamp far to the left, soft reflections on slightly damp asphalt. Shot on a 35mm lens at f/2 from a few steps away, the friend nearest the camera slightly out of focus, real skin texture with pores and a little shine, no beauty retouching, nobody posing for the camera. The storefront is generic and unbranded; the only readable text is a small glowing sign reading 'OPEN 24H'. Documentary photography, muted colours, faint film grain.

02

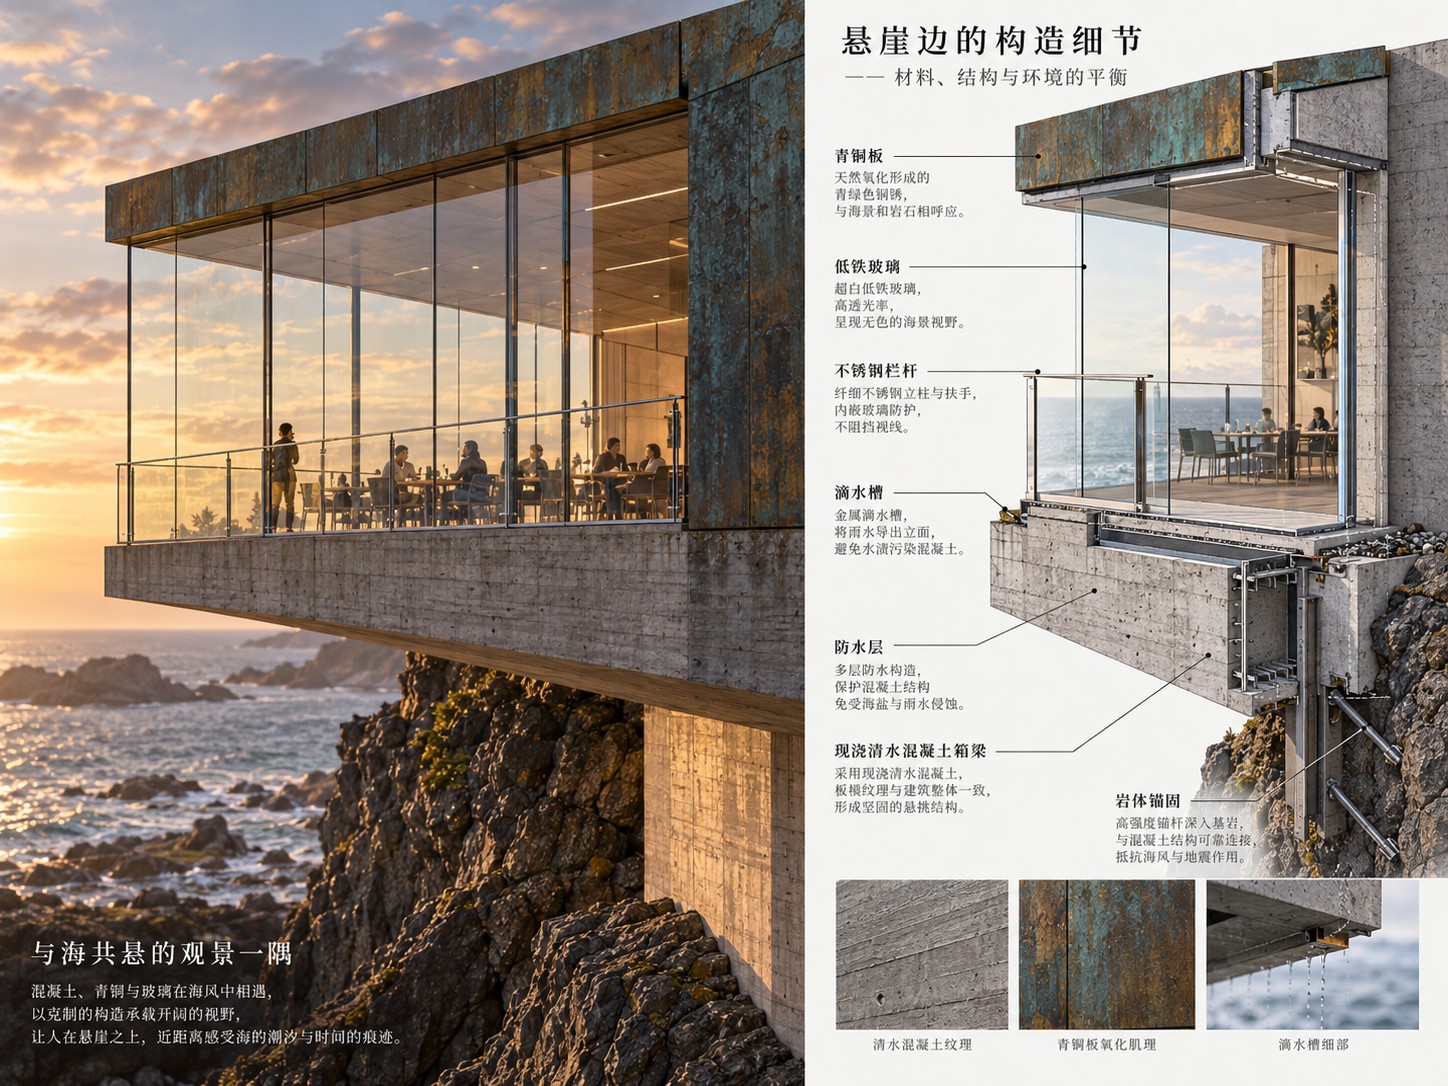
Une photo et son dessin de construction, côte à côte

À gauche un restaurant vitré en porte-à-faux au-dessus de la mer, à droite son détail en coupe, avec sept annotations en chinois du bardage en bronze patiné jusqu’aux ancrages dans la roche. Chaque caractère des annotations reste lisible, et le dessin correspond à la photo pièce par pièce.

Une photo et son dessin de construction, côte à côte: A two-part editorial spread on one 4:3 canvas. Left half: a photorealistic architectural photograph at golden hour of a small glass-walled restaurant cantilevered from a dark basalt cliff over the sea, the box clad in green-patinated bronze panels and carried on a raw board-marked concrete beam, floor to ceiling low-iron glazing with a thin stainless steel guardrail, diners at tables inside lit by the low sun, waves breaking on the rocks below, soft clouds. Right half on warm off-white paper: an annotated construction detail of the same cantilever drawn as a clean cut-away render with hairline leader lines, titled '悬崖边的构造细节' with the subtitle '材料、结构与环境的平衡', and seven callouts in Chinese reading '青铜板', '低铁玻璃', '不锈钢栏杆', '滴水槽', '防水层', '现浇清水混凝土箱梁', '岩体锚固', each with two or three short lines of explanation in small grey type; along the bottom three small material swatches captioned '清水混凝土纹理', '青铜板氧化肌理', '滴水槽细部'. Bottom left of the photograph a white caption block reading '与海共悬的观景一隅' with three short lines of copy beneath. Editorial typography, generous margins, every character rendered clearly, no other text.
Prompt

A two-part editorial spread on one 4:3 canvas. Left half: a photorealistic architectural photograph at golden hour of a small glass-walled restaurant cantilevered from a dark basalt cliff over the sea, the box clad in green-patinated bronze panels and carried on a raw board-marked concrete beam, floor to ceiling low-iron glazing with a thin stainless steel guardrail, diners at tables inside lit by the low sun, waves breaking on the rocks below, soft clouds. Right half on warm off-white paper: an annotated construction detail of the same cantilever drawn as a clean cut-away render with hairline leader lines, titled '悬崖边的构造细节' with the subtitle '材料、结构与环境的平衡', and seven callouts in Chinese reading '青铜板', '低铁玻璃', '不锈钢栏杆', '滴水槽', '防水层', '现浇清水混凝土箱梁', '岩体锚固', each with two or three short lines of explanation in small grey type; along the bottom three small material swatches captioned '清水混凝土纹理', '青铜板氧化肌理', '滴水槽细部'. Bottom left of the photograph a white caption block reading '与海共悬的观景一隅' with three short lines of copy beneath. Editorial typography, generous margins, every character rendered clearly, no other text.

03

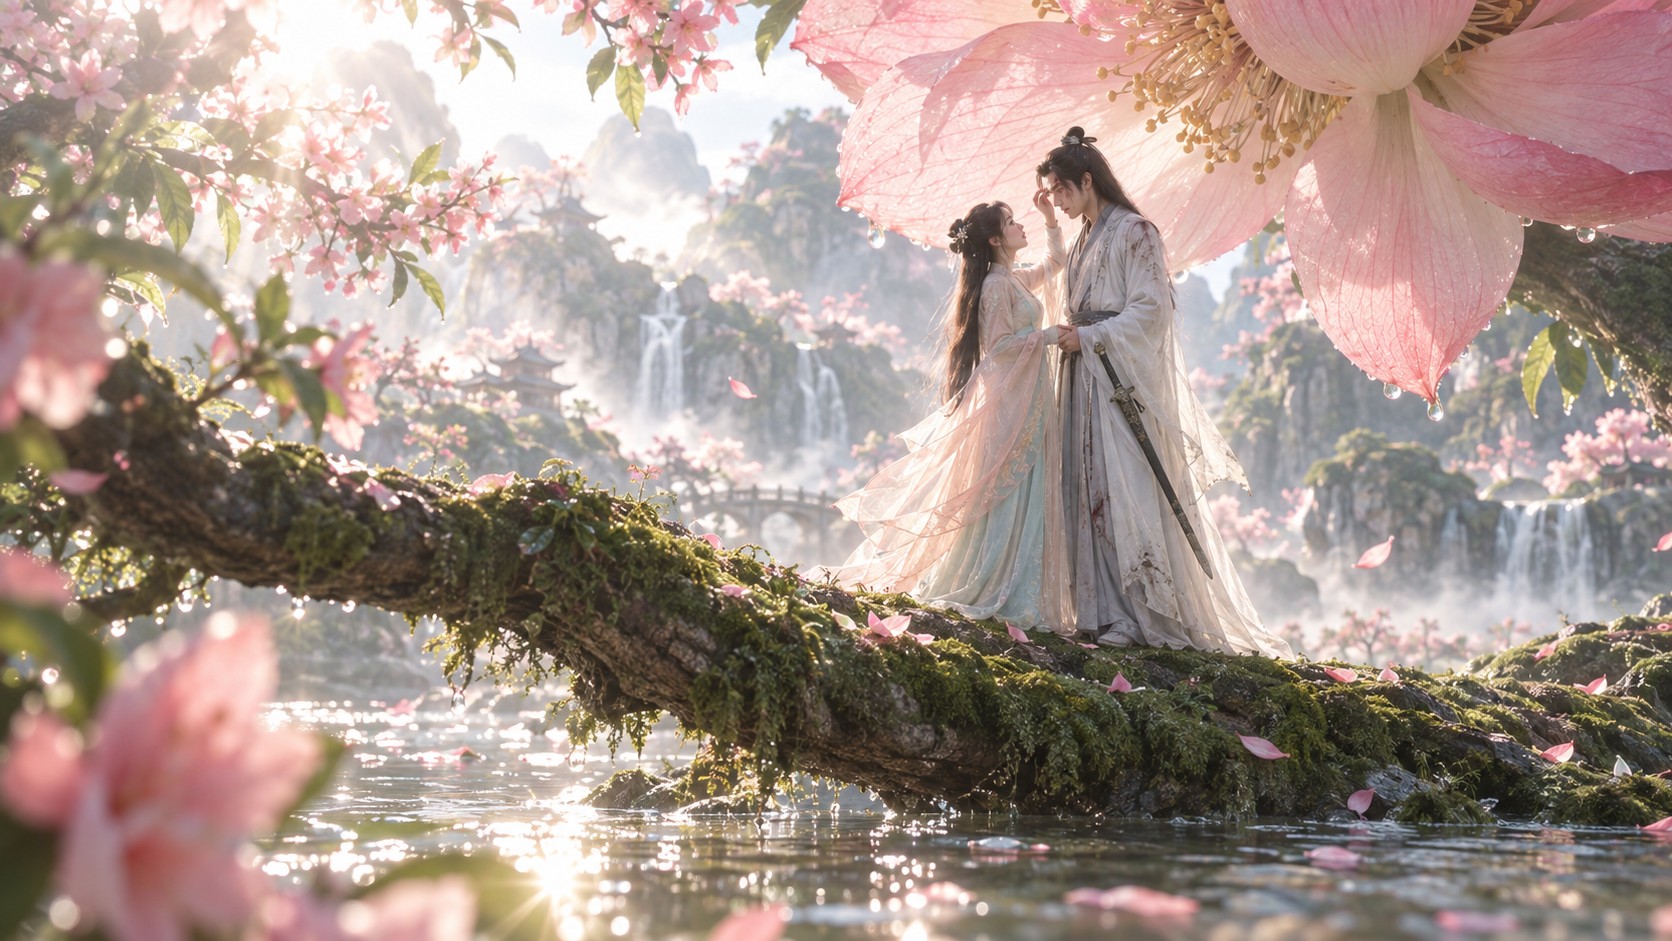
Une fleur grande comme une voile

Deux silhouettes en hanfu sur un tronc moussu au-dessus d’une rivière, sous un pétale rose translucide bordé de rosée, des pics karstiques et des cascades qui se fondent dans la brume. Contre-jour, brume et mousse mouillée forment une seule lumière, et les plis du tissu sont nets là où tombe la mise au point.

Une fleur grande comme une voile: Cinematic wide shot in a Chinese xianxia fantasy world, photoreal CG. A young woman in flowing pale pink and mint layered hanfu with long black hair and a jade hairpin stands on a moss-covered fallen tree trunk that bridges a shallow river, gently touching the cheek of a young swordsman in white and grey robes with a sword at his hip; both in profile, close together. Above them a giant translucent pink blossom leans over the trunk, its petals the size of sails with dewdrops on the edges and golden stamens. Behind them misty karst peaks with waterfalls, a stone arch bridge and distant pavilion roofs, peach trees in full bloom, petals drifting down onto the water. Backlit morning sun, volumetric haze, soft lens bloom, sparkle and ripples on the water in the foreground, shallow depth of field on the blossoms nearest the camera. Ethereal and romantic, with detailed fabric and wet moss textures.
Prompt

Cinematic wide shot in a Chinese xianxia fantasy world, photoreal CG. A young woman in flowing pale pink and mint layered hanfu with long black hair and a jade hairpin stands on a moss-covered fallen tree trunk that bridges a shallow river, gently touching the cheek of a young swordsman in white and grey robes with a sword at his hip; both in profile, close together. Above them a giant translucent pink blossom leans over the trunk, its petals the size of sails with dewdrops on the edges and golden stamens. Behind them misty karst peaks with waterfalls, a stone arch bridge and distant pavilion roofs, peach trees in full bloom, petals drifting down onto the water. Backlit morning sun, volumetric haze, soft lens bloom, sparkle and ripples on the water in the foreground, shallow depth of field on the blossoms nearest the camera. Ethereal and romantic, with detailed fabric and wet moss textures.

04

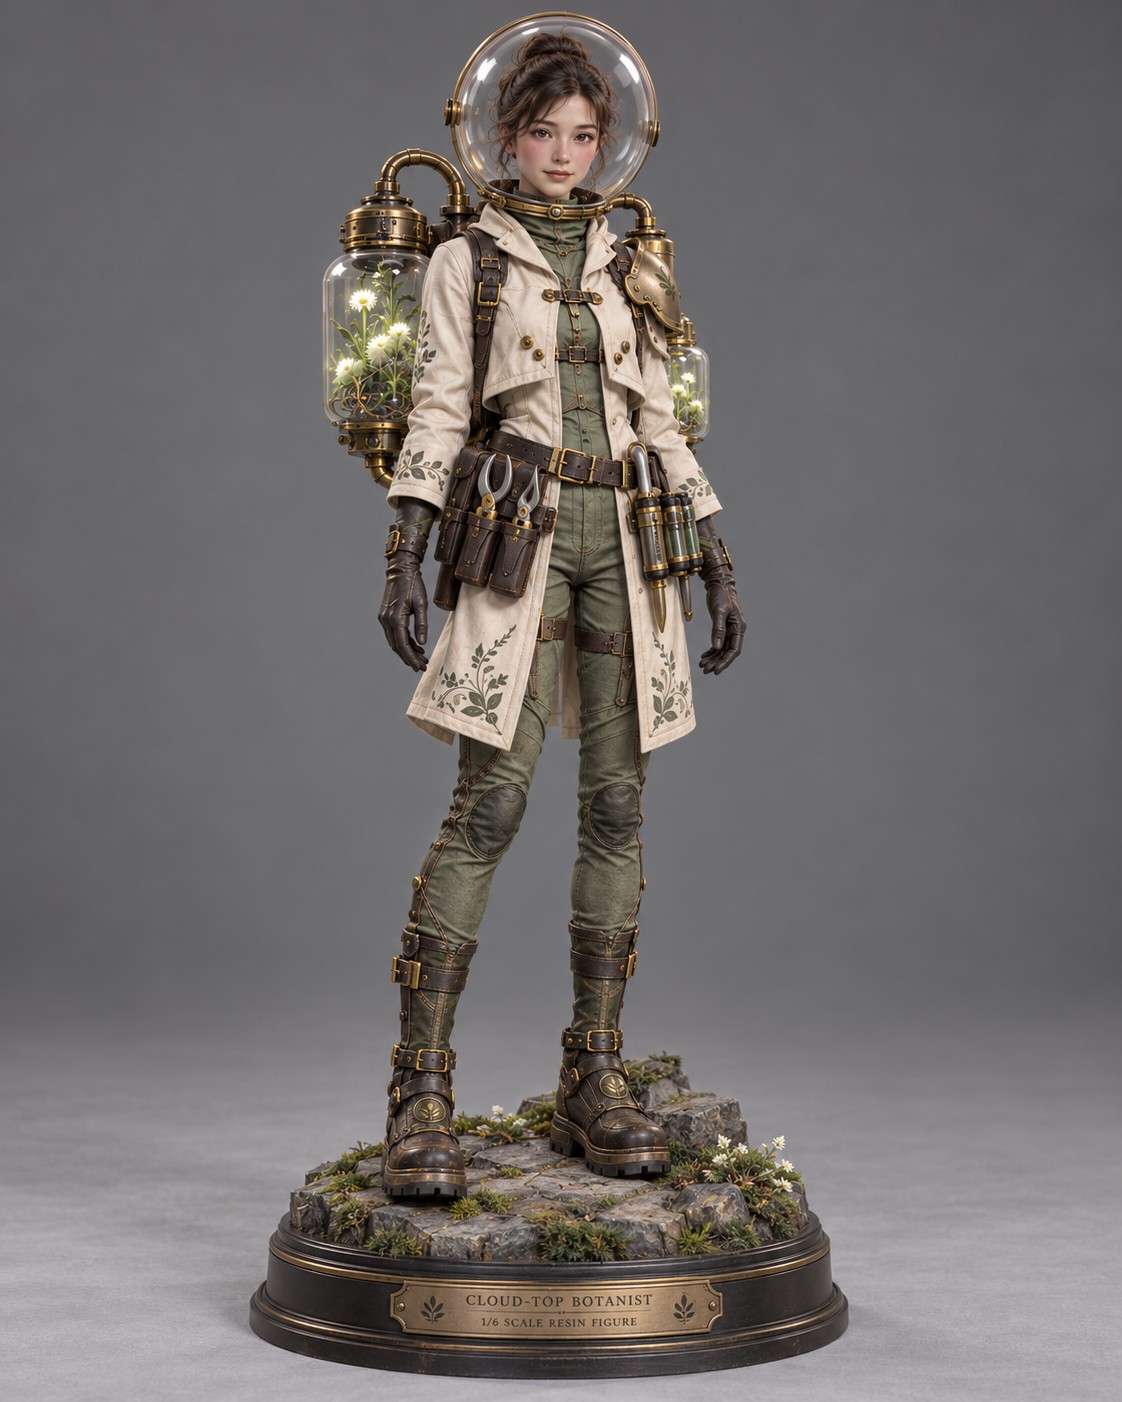
Une figurine qu’on pourrait saisir

Une figurine de botaniste à l’échelle 1/6 sur son socle, casque de verre, réservoirs terrarium en laiton et manteau de toile brodé, photographiée comme une fiche produit. Verre, laiton, cuir et tissu gardent chacun leur finition, et la plaque porte « CLOUD-TOP BOTANIST » en entier.

Une figurine qu’on pourrait saisir: Studio product photograph of a 1/6 scale resin collectible figure: a young woman botanist explorer standing on a rocky mossy base with tiny white wildflowers, wearing a glass dome helmet with brass fittings, a cream canvas coat with green leaf embroidery over an olive utility suit, a leather tool belt holding pruning shears and glass vials, dark leather gloves and tall buckled boots. On her back two brass and glass terrarium canisters with glowing white daisies inside. The figure stands on a round black plinth with a brass plaque reading 'CLOUD-TOP BOTANIST' and a smaller line '1/6 SCALE RESIN FIGURE'. Plain grey seamless backdrop, soft even studio light with a gentle shadow under the base, sharp focus from helmet to boots, visible material finishes: matte fabric, polished brass, clear glass, worn leather. Vertical 3:4 framing.
Prompt

Studio product photograph of a 1/6 scale resin collectible figure: a young woman botanist explorer standing on a rocky mossy base with tiny white wildflowers, wearing a glass dome helmet with brass fittings, a cream canvas coat with green leaf embroidery over an olive utility suit, a leather tool belt holding pruning shears and glass vials, dark leather gloves and tall buckled boots. On her back two brass and glass terrarium canisters with glowing white daisies inside. The figure stands on a round black plinth with a brass plaque reading 'CLOUD-TOP BOTANIST' and a smaller line '1/6 SCALE RESIN FIGURE'. Plain grey seamless backdrop, soft even studio light with a gentle shadow under the base, sharp focus from helmet to boots, visible material finishes: matte fabric, polished brass, clear glass, worn leather. Vertical 3:4 framing.

Ce que vous pouvez faire avec GPT Image 2.5

Des photos de groupe où chaque visage est une personne

Visuels de campagne, pages d’équipe et posts sociaux avec cinq ou six personnes dans le cadre, chacune avec ses traits et son expression, éclairées par la seule lumière que la scène possède vraiment.

Des mises en page annotées en plusieurs langues

Fiches produit, détails de construction et schémas explicatifs qui associent une image photoréaliste à des annotations, où les petits caractères en chinois comme en anglais restent lisibles.

Des scènes et des produits qui ont l’air finis

Des images cinématographiques pour un pitch, ou des figurines et des emballages photographiés comme une fiche produit, où le verre, le métal, le tissu et la peau gardent chacun leur finition.

À qui s'adresse GPT Image 2.5

GPT Image 2.5 est le modèle d'images d'OpenAI sorti en septembre 2026, et Vidney réunit ses deux variantes sur une même page : Flare, la plus rapide des deux et le choix par défaut d'OpenAI pour l'essentiel du travail, et Sunburst, la plus lente, taillée pour les retouches précises. Les deux acceptent le texte vers image et l'image vers image, prennent jusqu'à quatre images de référence et couvrent le 1:1, le 4:3, le 3:4, le 16:9 et le 9:16 en 1K, 2K ou 4K, le 4K représentant environ 8,3 millions de pixels. La qualité est fixée ici sur le palier intermédiaire ; fonds transparents, retouche au masque et paliers de qualité supérieurs restent fermés pour l'instant. Choisissez-le quand les mots dans l'image doivent être justes du premier coup.

Comment générer des images avec GPT Image 2.5

Créez des images IA avec GPT Image 2.5 sur Vidney en trois étapes.

Glowing panels with one model selected from severalStreams of light forming into an emerging imageA finished image materializing from a vortex of glowing light

GPT Image 2.5 vs Muse Image vs Midjourney V8.1 vs Grok Imagine Image 2.0

Spécifications face à des modèles similaires, tous disponibles sur Vidney.

GPT Image 2.5Muse ImageMidjourney V8.1Grok Imagine Image 2.0
Modes de tâcheTexte vers image · Image vers imageTexte vers image · Image vers imageTexte vers image · Image vers imageTexte vers image · Image vers image
Résolution1K · 2K · 4K1K · 2K
Coût3 à 5 crédits par génération3 crédits par génération18 crédits par génération9 à 15 crédits par génération

Modèles associés

D'autres modèles image IA à exécuter sur Vidney.

En ligne

Générez des images IA avec GPT Image 2.0 : texte vers image et image vers image, depuis un seul espace de travail Vidney.

3 crédits par génération
En ligne

Générez des images IA avec GPT Image 1.5 : texte vers image et image vers image, depuis un seul espace de travail Vidney.

3 crédits par génération
En ligne

Le modèle d'images de Meta relit son propre brouillon avant de vous rendre l'image.

3 crédits par génération
En ligne

Générez des images IA avec Nano Banana 2 : texte vers image et image vers image, depuis un seul espace de travail Vidney.

3 crédits par génération
MidjourneyMidjourney V7
En ligne

Générez des images IA avec Midjourney V7 : texte vers image et image vers image, depuis un seul espace de travail Vidney.

6 crédits par génération
En ligne

Générez des images IA avec Nano Banana : texte vers image et image vers image, depuis un seul espace de travail Vidney.

6 crédits par génération

Questions fréquentes

Qu'est-ce que GPT Image 2.5 ?

GPT Image 2.5 est un modèle image IA que vous pouvez exécuter sur Vidney. Il prend en charge texte vers image et image vers image depuis un seul espace de travail.

Combien coûte GPT Image 2.5 par génération ?

GPT Image 2.5 coûte 3 à 5 crédits par génération. Le coût exact en crédits est affiché sur le bouton de génération avant le lancement.

Quels formats d'image GPT Image 2.5 prend-il en charge ?

GPT Image 2.5 prend en charge les formats d'image suivants : 1:1, 4:3, 3:4, 16:9, 9:16.

GPT Image 2.5 est-il gratuit ?

Oui, vous pouvez démarrer avec GPT Image 2.5 gratuitement sur Vidney grâce aux crédits offerts à l'inscription, sans aucune carte bancaire requise pour l'essayer. Ensuite, chaque génération coûte 3 à 5 crédits par génération, et le coût exact reste toujours affiché sur le bouton de génération avant que vous ne dépensiez le moindre crédit.

Puis-je utiliser les images de GPT Image 2.5 à des fins commerciales ?

Oui. Les images que vous générez avec GPT Image 2.5 sur Vidney vous appartiennent et sont utilisables dans vos projets commerciaux : publicités, posts sur les réseaux sociaux, travail client et contenu produit. Vous conservez les droits sur le rendu ; Vidney se charge uniquement de la génération et du stockage.

GPT Image 2.5 ajoute-t-il un filigrane ?

Non. Les images générées avec GPT Image 2.5 sur Vidney sont livrées propres, sans filigrane Vidney, prêtes à être publiées ou remises telles quelles à un client.

Quelles sont les meilleures alternatives à GPT Image 2.5 ?

Les alternatives à GPT Image 2.5 les plus proches sur Vidney sont Muse Image, Midjourney V8.1 et Grok Imagine Image 2.0. Elles fonctionnent toutes dans le même espace de travail, avec un seul solde de crédits : vous pouvez donc lancer le même prompt sur chacune et comparer les résultats côte à côte.

Ai-je besoin d'une clé API ou d'un compte de fournisseur pour utiliser GPT Image 2.5 ?

Non. Vidney exécute GPT Image 2.5 pour vous : aucune clé API à gérer ni compte de fournisseur distinct à configurer.

Créez avec GPT Image 2.5 dès maintenant