Generador de Imágenes IA
Imagen a Imagen
Transforma una imagen de referencia en una nueva imagen con IA. Elige cualquier modelo compatible.
Lo que puedes crear
Prompts reales y sus resultados de los modelos disponibles aquí.
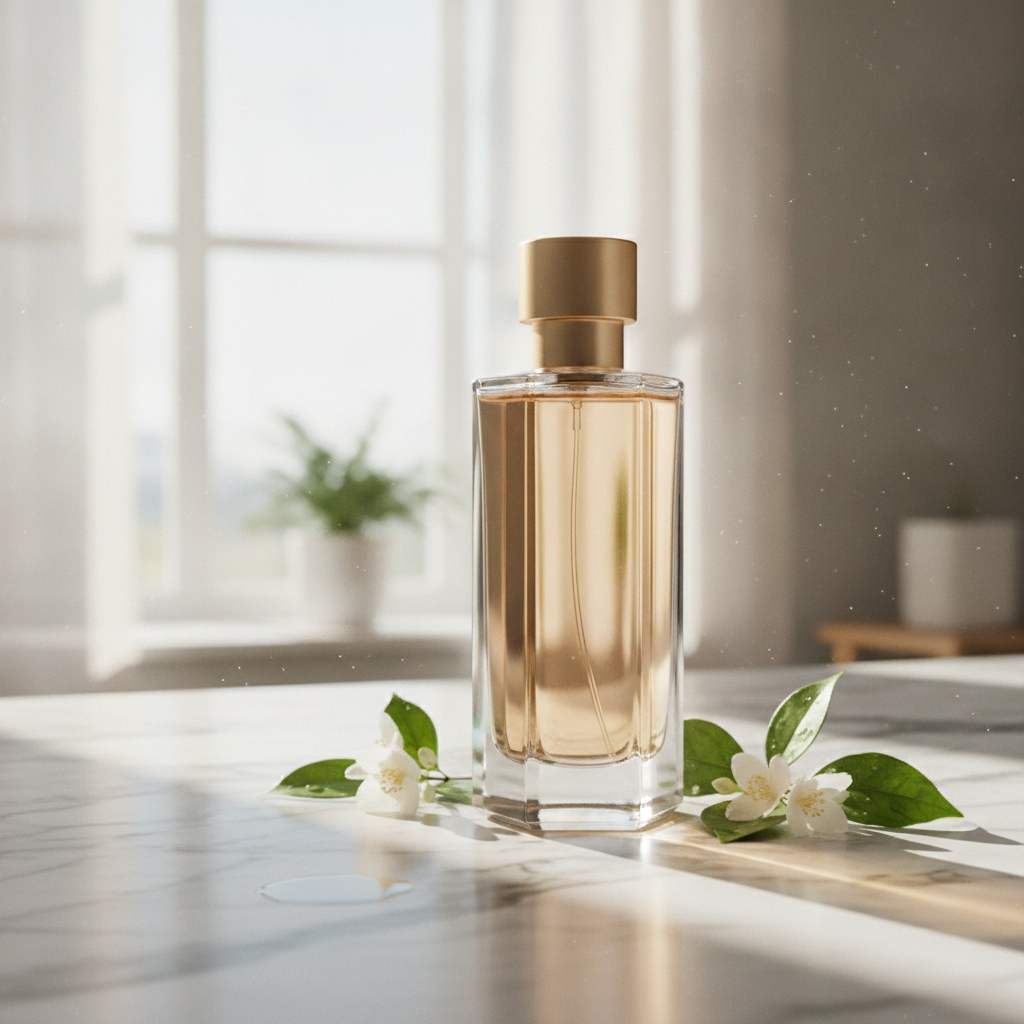
A sleek perfume bottle from a studio shot placed on a sunlit marble countertop with soft morning light, composited as one natural scene

E-commerce hero photograph of a stand-up kraft paper coffee bag with a matte cream label, square format, on a seamless warm beige background with a few roasted coffee beans scattered in front. The label text is large, crisp and spelled exactly: NORTH RIDGE in a bold black serif across the top, COFFEE ROASTERS in small spaced capitals under it, ETHIOPIA GUJI in medium black capitals in the middle, Washed · Light Roast on the next line, Peach · Jasmine · Honey on the line below, and 250 g at the bottom right of the label. Soft window light from the left, a gentle shadow, realistic paper texture and printing. No other text, no logos.

Photoreal interior of a small Japanese tea house at dawn during light rain, square format: tatami with visible weave, a low black lacquer table with a single ceramic cup and a thread of steam, shoji screens glowing with grey morning light, wet dark stepping stones and a bamboo ladle in the garden seen through the open engawa, a blank hanging scroll on the wall. Directional light from the screens on the left, soft shadows, fine wood grain on every post, precise texture at every scale from the cup to the garden. 50mm lens look, deep focus. No people, no text, no watermark.
Modelos para Imagen a Imagen
20 modelos admiten este tipo de tarea. Abre cualquiera para ver sus especificaciones completas.
El Wan 2.7 de Alibaba crea el fotograma y luego lo mueve: imágenes fijas, ediciones y clips con sonido de una sola familia de modelos.
El Flux 3 pequeño y rápido: una imagen desde un prompt, o un solo cambio sobre hasta diez referencias.
El nuevo modelo de imagen Flash de Google: las palabras vuelven bien escritas y la cara aguanta la siguiente edición.
Dos velocidades en una misma página, y las palabras que escribes vuelven bien escritas.
El modelo de imagen de Meta revisa su propio borrador antes de devolverte la imagen.
El aspecto Midjourney que ya conoces, con titulares que por fin se leen.
Genera imagen con IA usando Grok Imagine Image 2.0: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
La versión de Qwen Image 3.0 con más detalle para generación pulida y ediciones fieles al origen.
Un solo modelo para escribir una imagen nueva desde texto y revisar una existente con una instrucción directa.
La versión ligera de Nano Banana de Google: imágenes 1K y ediciones rápidas para producir en volumen.
Genera imagen con IA usando Nano Banana 2: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando Nano Banana Pro: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando Seedream 5.0 Lite: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando GPT Image 2.0: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando Midjourney V7: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando Nano Banana: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando Seedream 4.5: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando Flux Kontext: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando GPT Image 1.5: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Genera imagen con IA usando Seedream 4.0: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.
Cómo usar la herramienta Imagen a Imagen de Vidney
Crea imagen con IA usando la herramienta Imagen a Imagen de Vidney en tres pasos.
Preguntas frecuentes
¿Qué es la herramienta Imagen a Imagen de Vidney?
La herramienta Imagen a Imagen de Vidney te permite crear imagen con IA a partir de imagen a imagen usando cualquier modelo compatible en un solo espacio de trabajo.
¿Qué modelos puedo usar con la herramienta Imagen a Imagen?
Puedes usar Wan 2.7, Flux 3 Klein, Nano Banana 2.1, GPT Image 2.5, Muse Image, Midjourney V8.1, Grok Imagine Image 2.0, Qwen Image 3.0 Pro, Qwen Image 3.0, Nano Banana 2 Lite, Nano Banana 2, Nano Banana Pro, Seedream 5.0 Lite, GPT Image 2.0, Midjourney V7, Nano Banana, Seedream 4.5, Flux Kontext, GPT Image 1.5 y Seedream 4.0.
¿Necesito una clave API para usar la herramienta Imagen a Imagen?
No. Vidney se encarga del acceso a proveedores y la facturación: no hay claves API que gestionar ni cuentas de proveedor que configurar.