Vidney

Generador de Imágenes IA

GPT Image 2.5

Dos velocidades en una misma página, y las palabras que escribes vuelven bien escritas.

Espacio de trabajo Vidney

21 modelos
0/2000
Necesarios: 3 créditos

Resultado

Muestra

GPT Image 2.5: ¿Flare o Sunburst?

GPT Image 2.5 llega en dos versiones y esta página ofrece ambas al mismo precio. Lo que las separa es la velocidad frente a la precisión.

OpenAI publica GPT Image 2.5 como dos variantes detrás de una misma interfaz. Lo que OpenAI destaca de esta generación, el texto entre comillas tal como se escribió y las ediciones que solo tocan el elemento nombrado, lo hacen igual de bien las dos variantes, y un prompt cargado puede necesitar una segunda pasada en cualquiera de ellas. Flare es la que OpenAI señala como opción predeterminada para la mayoría de los usos: genera una imagen en aproximadamente la mitad del tiempo que necesitaba GPT Image 2. Sunburst pone la precisión por delante: conserva con más fidelidad los detalles complejos y tarda más en terminar. En Vidney, ambas aceptan los mismos prompts, hasta cuatro imágenes de referencia, los mismos cinco formatos y los mismos tamaños 1K, 2K y 4K, y cuestan los mismos créditos en cada tamaño. La elección nunca toca tu saldo, solo el reloj y el resultado.

La rápida

Flare

La mayor parte del trabajo debería empezar con Flare. Lo que Flare añade es velocidad: vuelve lo bastante rápido para iterar un diseño en lugar de esperarlo, y en nuestras propias pruebas una imagen 4K terminó en 47 segundos. La rotulación limpia y las ediciones acotadas por las que se conoce a esta generación están igualmente aquí, solo que más rápido.

Elígela para

  • Primeros borradores y exploración de direcciones
  • Series de variantes sobre un mismo brief
  • Pantallas y carteles que pasarán por varias revisiones
La precisa

Sunburst

Sunburst es la más precisa de las dos para editar, pensada para la imagen en la que nada puede moverse. Nombra un elemento y el resto de la imagen debe quedarse donde está; en 4K, los detalles finos como la letra pequeña siguen leyéndose al hacer zoom. Ese cuidado se paga en tiempo: la misma imagen 4K que Flare terminó en 47 segundos le llevó a Sunburst 64 segundos.

Elígela para

  • Ediciones en las que solo puede cambiar la parte nombrada
  • Una línea de producto que debe coincidir con una toma aprobada
  • Trabajos en 4K que se verán en grande o impresos

Empieza en Flare y cambia a Sunburst en cuanto una edición tenga que mantenerse o un detalle deba resistir una mirada de cerca. Ambas están en el menú de modelos del generador de arriba, como GPT Image 2.5 Flare y GPT Image 2.5 Sunburst, con los mismos créditos.

Lo que GPT Image 2.5 hace bien

01

Cinco caras, ninguna igual

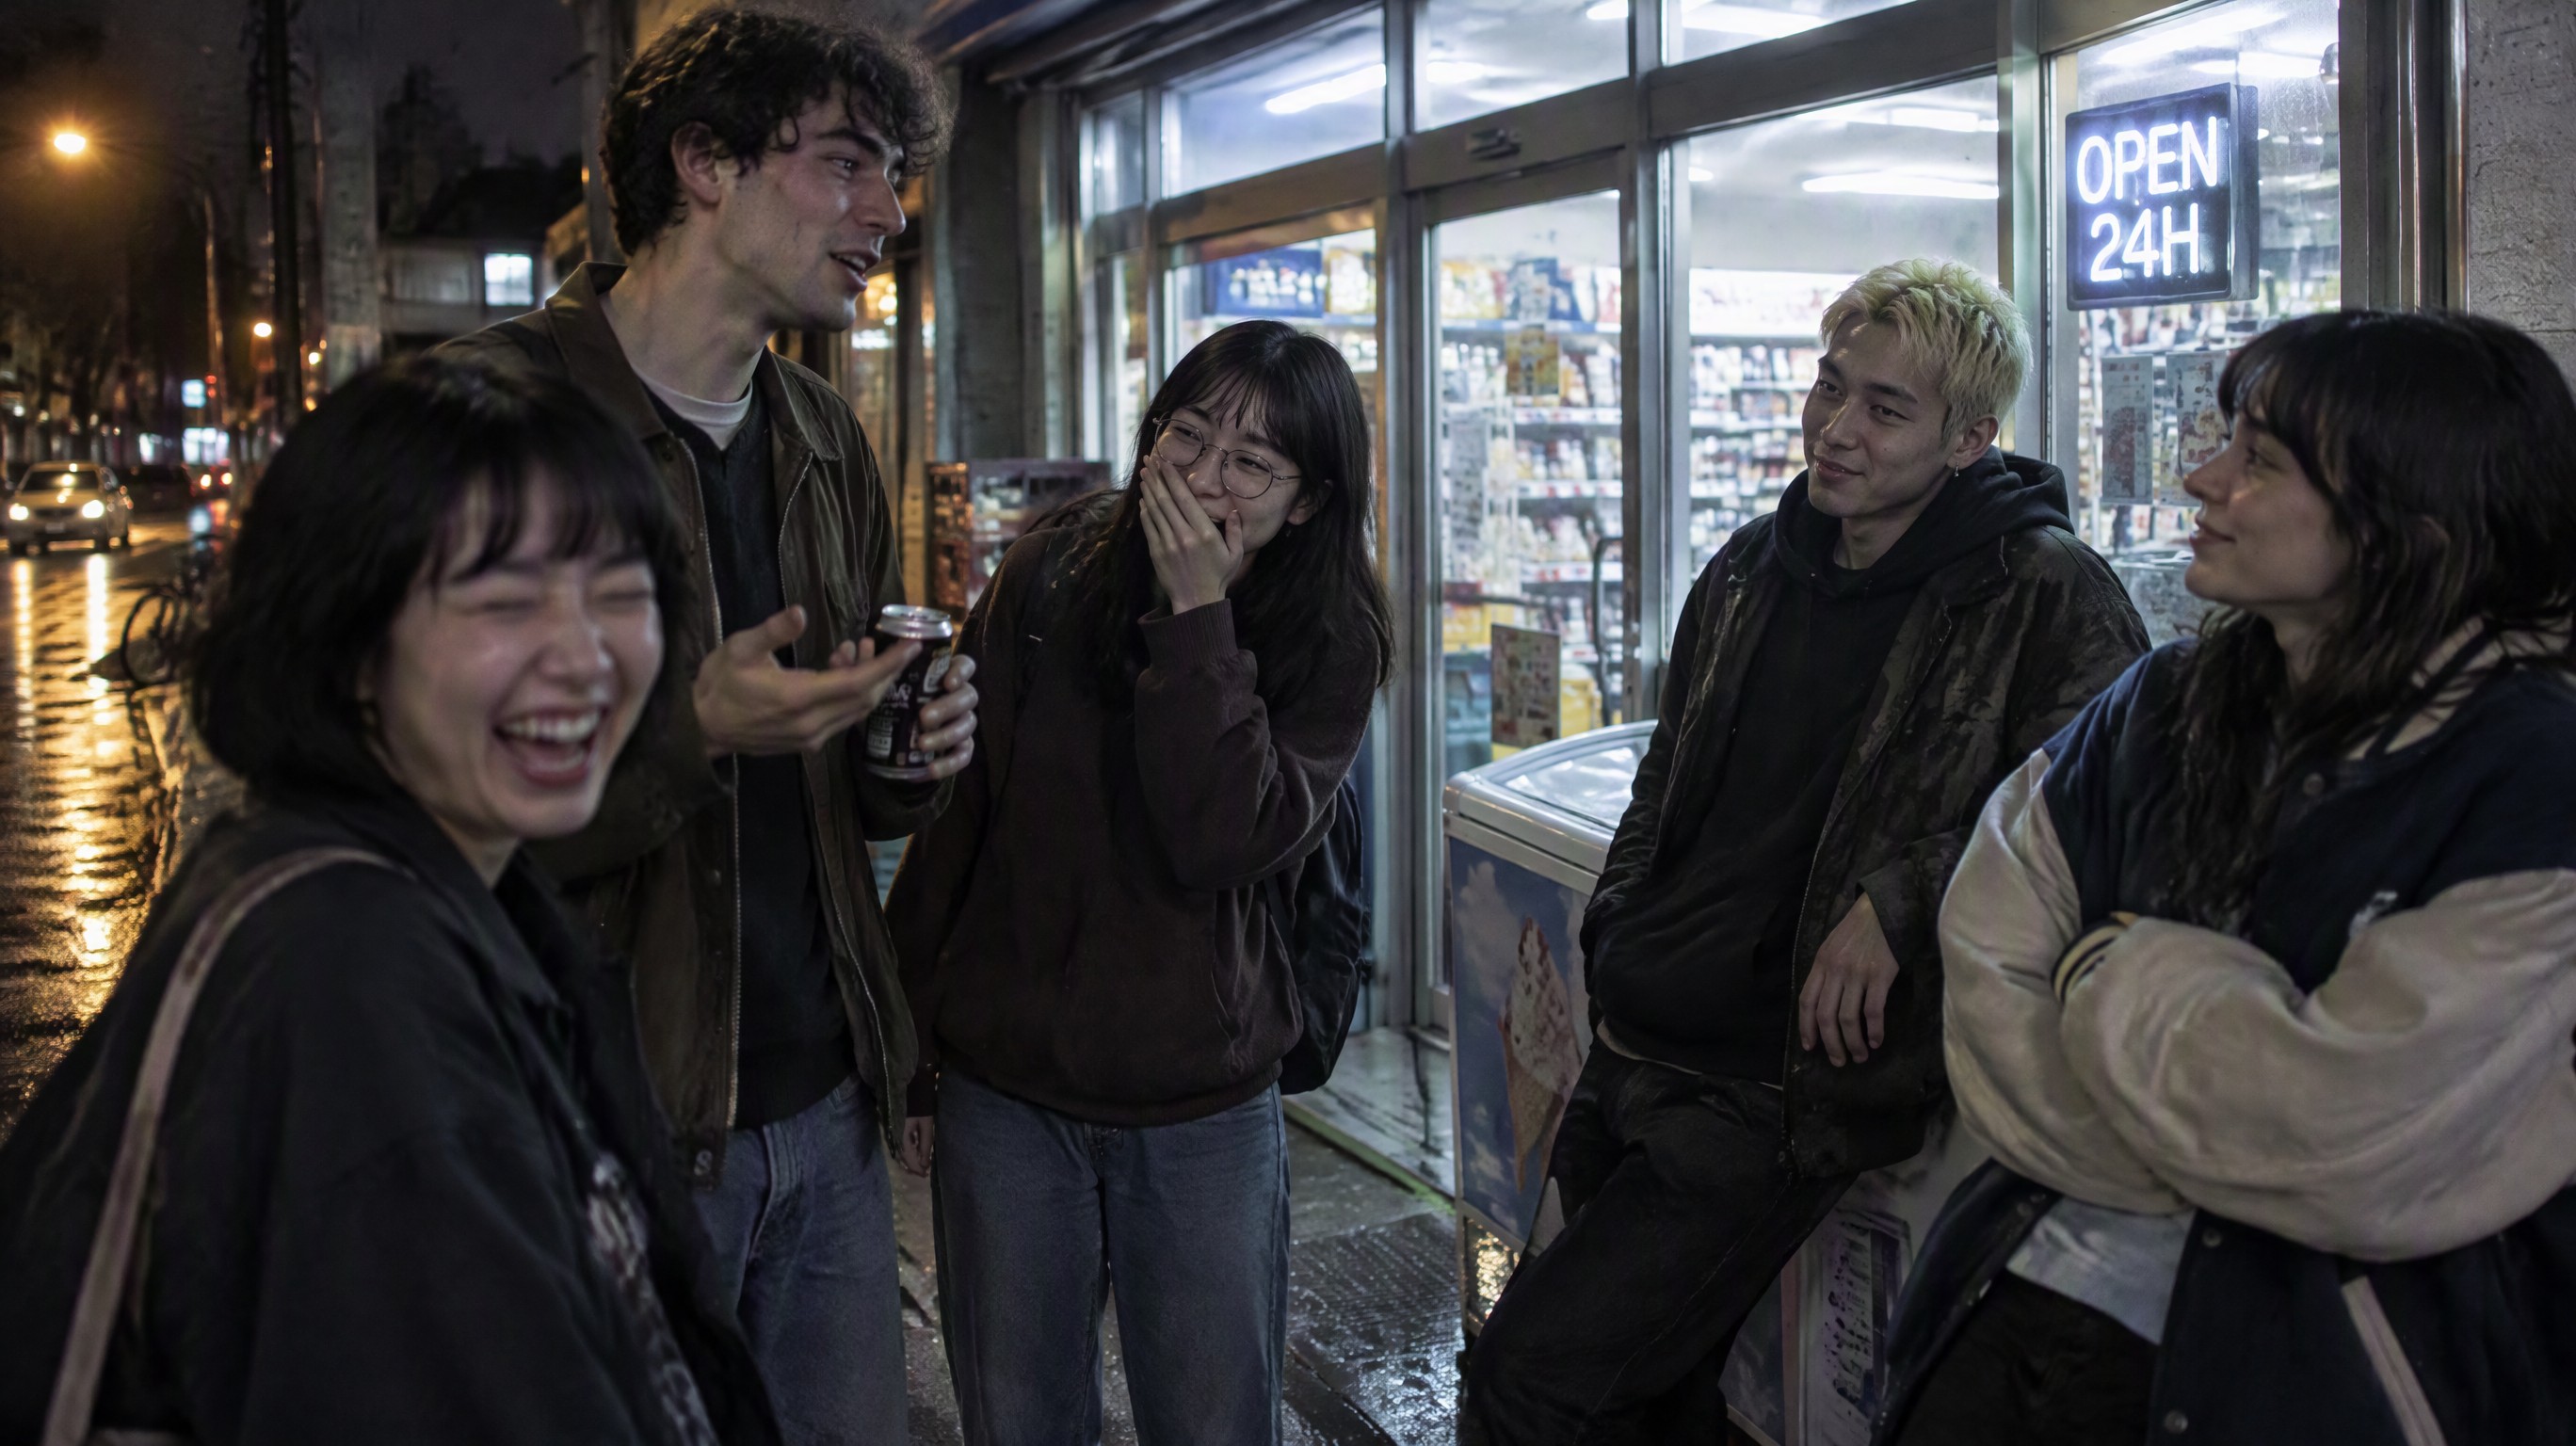
Cinco amigos frente a una tienda abierta toda la noche, iluminados solo por el escaparate y una farola. Cada cara es una persona distinta, una risa diferente, unos ojos diferentes, piel real bajo la luz dura de los fluorescentes, y nadie posa para la cámara.

Cinco caras, ninguna igual: Photorealistic candid photograph of five friends in their early twenties hanging out on the sidewalk in front of a small 24-hour convenience store late at night, laughing and talking in the middle of a story. Each face is clearly different and clearly lit: a young woman with a short black bob laughing with her eyes squeezed shut, a tall young man mid-sentence gesturing with a canned coffee, a young woman in round glasses covering her grin with one hand, a young man with bleached hair leaning against the ice-cream freezer by the door with a lopsided smirk, and a young woman in an oversized varsity jacket looking sideways at her friend with a fond half-smile. Natural mixed lighting only: cool white fluorescent light spilling from the store windows onto the pavement, one warm streetlamp far to the left, soft reflections on slightly damp asphalt. Shot on a 35mm lens at f/2 from a few steps away, the friend nearest the camera slightly out of focus, real skin texture with pores and a little shine, no beauty retouching, nobody posing for the camera. The storefront is generic and unbranded; the only readable text is a small glowing sign reading 'OPEN 24H'. Documentary photography, muted colours, faint film grain.
Prompt

Photorealistic candid photograph of five friends in their early twenties hanging out on the sidewalk in front of a small 24-hour convenience store late at night, laughing and talking in the middle of a story. Each face is clearly different and clearly lit: a young woman with a short black bob laughing with her eyes squeezed shut, a tall young man mid-sentence gesturing with a canned coffee, a young woman in round glasses covering her grin with one hand, a young man with bleached hair leaning against the ice-cream freezer by the door with a lopsided smirk, and a young woman in an oversized varsity jacket looking sideways at her friend with a fond half-smile. Natural mixed lighting only: cool white fluorescent light spilling from the store windows onto the pavement, one warm streetlamp far to the left, soft reflections on slightly damp asphalt. Shot on a 35mm lens at f/2 from a few steps away, the friend nearest the camera slightly out of focus, real skin texture with pores and a little shine, no beauty retouching, nobody posing for the camera. The storefront is generic and unbranded; the only readable text is a small glowing sign reading 'OPEN 24H'. Documentary photography, muted colours, faint film grain.

02

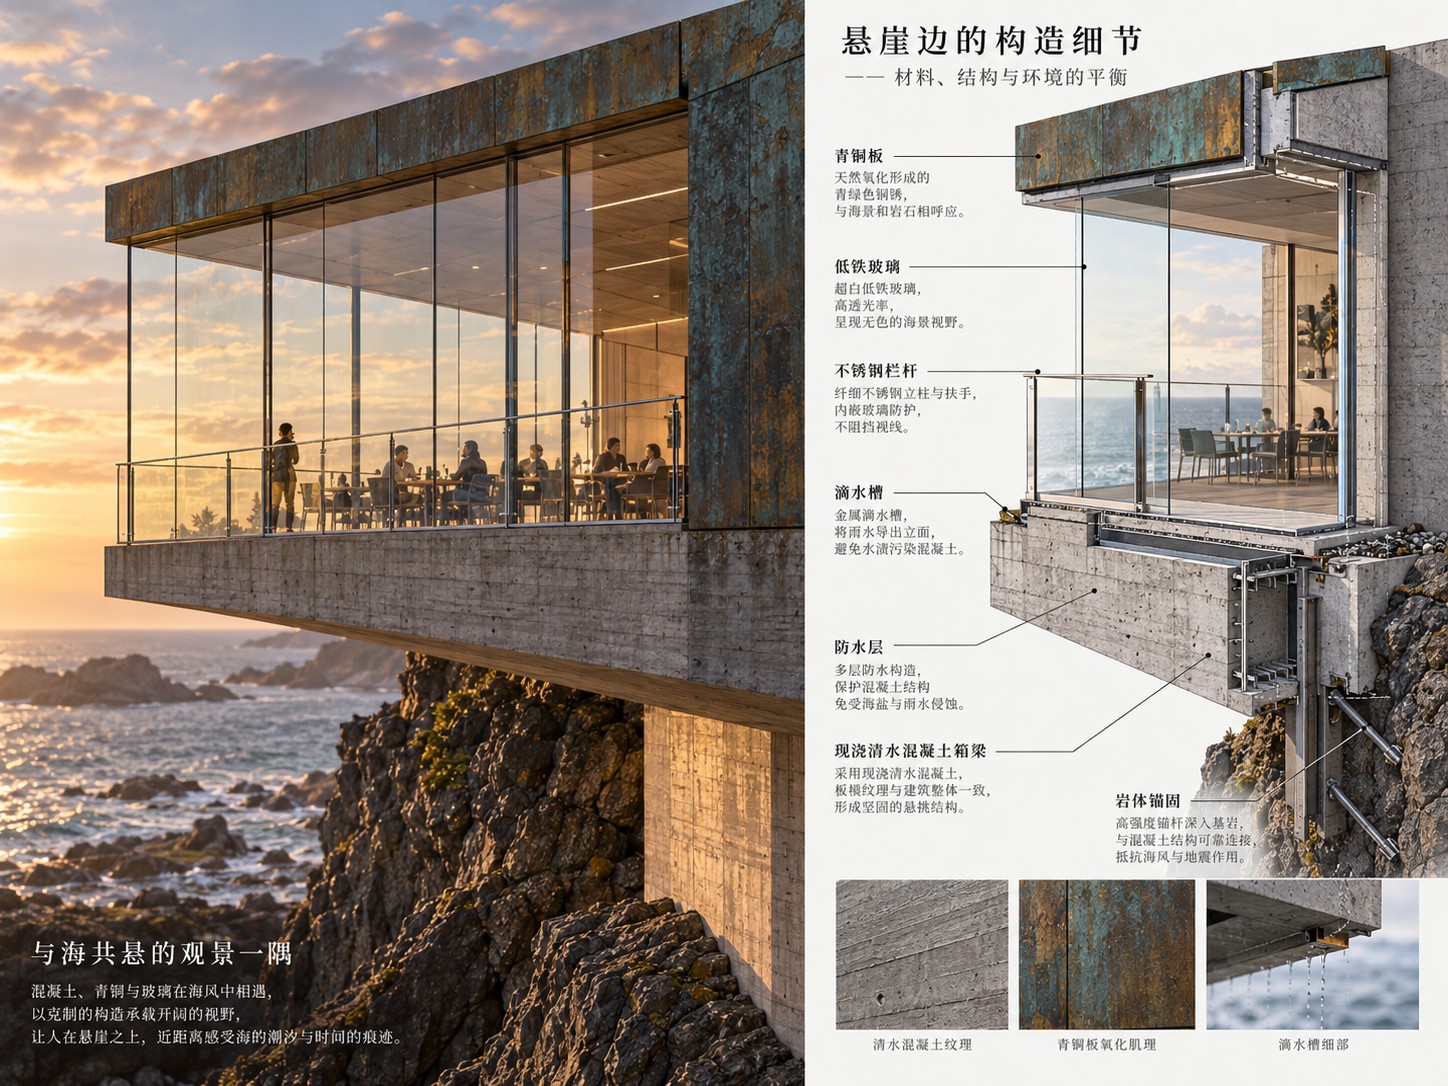
Una foto y su plano constructivo, lado a lado

A la izquierda un restaurante acristalado en voladizo sobre el mar, a la derecha su detalle en sección con siete anotaciones en chino, desde el revestimiento de bronce patinado hasta los anclajes en la roca. Cada carácter de las anotaciones sigue siendo legible, y el dibujo coincide con la foto pieza por pieza.

Una foto y su plano constructivo, lado a lado: A two-part editorial spread on one 4:3 canvas. Left half: a photorealistic architectural photograph at golden hour of a small glass-walled restaurant cantilevered from a dark basalt cliff over the sea, the box clad in green-patinated bronze panels and carried on a raw board-marked concrete beam, floor to ceiling low-iron glazing with a thin stainless steel guardrail, diners at tables inside lit by the low sun, waves breaking on the rocks below, soft clouds. Right half on warm off-white paper: an annotated construction detail of the same cantilever drawn as a clean cut-away render with hairline leader lines, titled '悬崖边的构造细节' with the subtitle '材料、结构与环境的平衡', and seven callouts in Chinese reading '青铜板', '低铁玻璃', '不锈钢栏杆', '滴水槽', '防水层', '现浇清水混凝土箱梁', '岩体锚固', each with two or three short lines of explanation in small grey type; along the bottom three small material swatches captioned '清水混凝土纹理', '青铜板氧化肌理', '滴水槽细部'. Bottom left of the photograph a white caption block reading '与海共悬的观景一隅' with three short lines of copy beneath. Editorial typography, generous margins, every character rendered clearly, no other text.
Prompt

A two-part editorial spread on one 4:3 canvas. Left half: a photorealistic architectural photograph at golden hour of a small glass-walled restaurant cantilevered from a dark basalt cliff over the sea, the box clad in green-patinated bronze panels and carried on a raw board-marked concrete beam, floor to ceiling low-iron glazing with a thin stainless steel guardrail, diners at tables inside lit by the low sun, waves breaking on the rocks below, soft clouds. Right half on warm off-white paper: an annotated construction detail of the same cantilever drawn as a clean cut-away render with hairline leader lines, titled '悬崖边的构造细节' with the subtitle '材料、结构与环境的平衡', and seven callouts in Chinese reading '青铜板', '低铁玻璃', '不锈钢栏杆', '滴水槽', '防水层', '现浇清水混凝土箱梁', '岩体锚固', each with two or three short lines of explanation in small grey type; along the bottom three small material swatches captioned '清水混凝土纹理', '青铜板氧化肌理', '滴水槽细部'. Bottom left of the photograph a white caption block reading '与海共悬的观景一隅' with three short lines of copy beneath. Editorial typography, generous margins, every character rendered clearly, no other text.

03

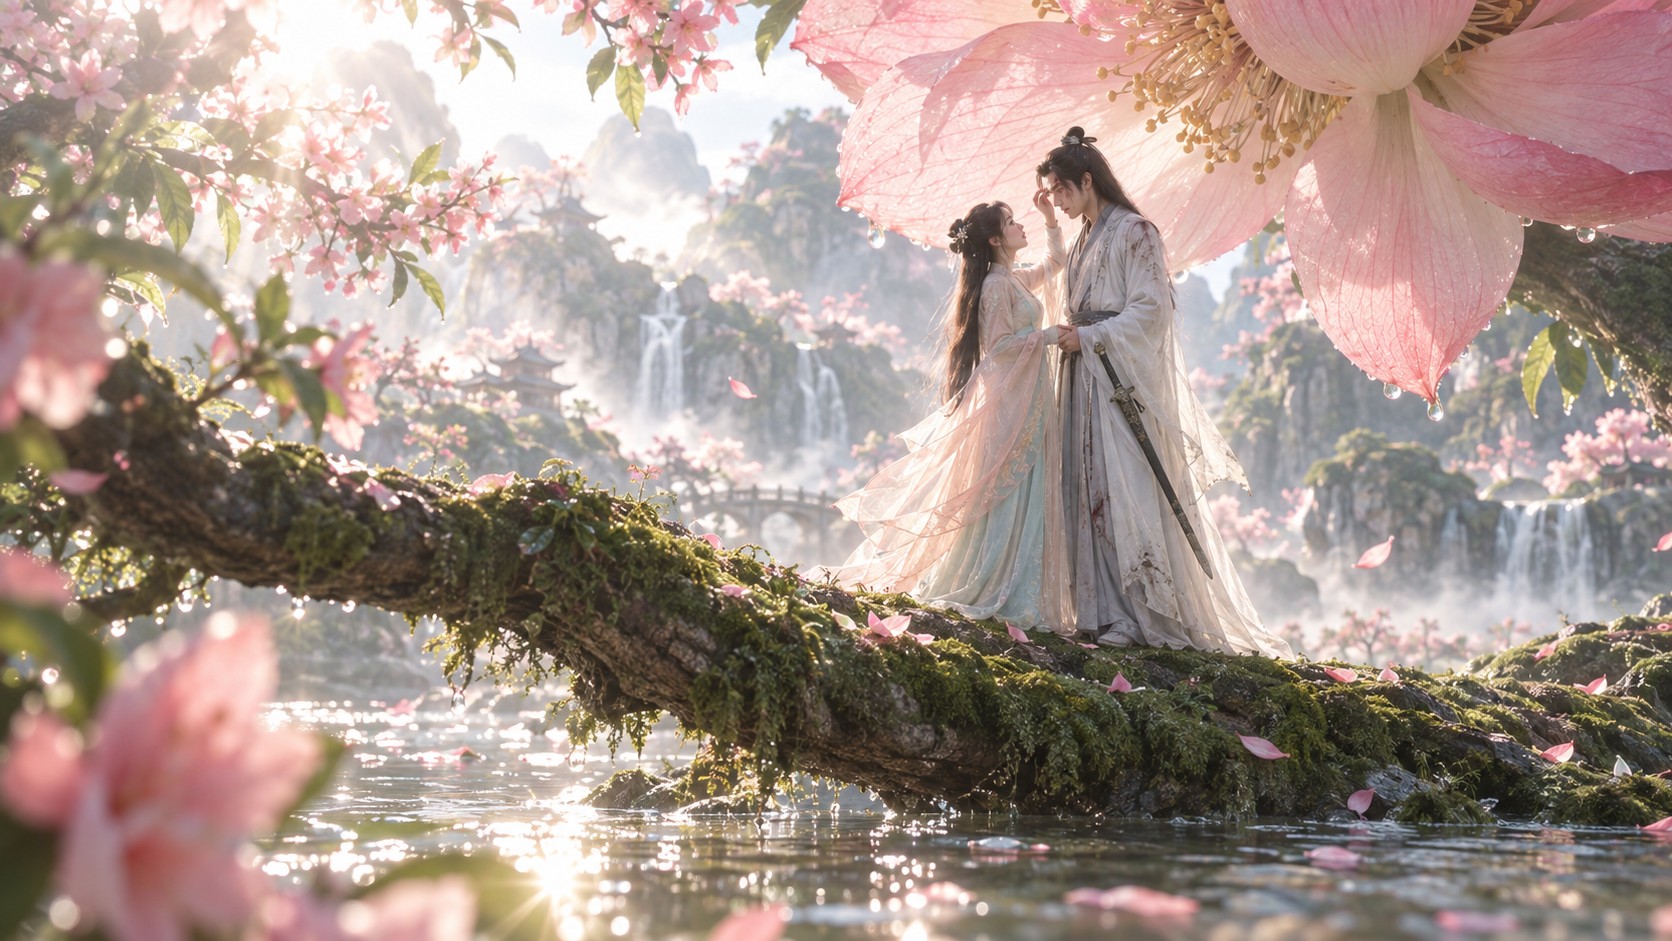
Una flor del tamaño de una vela de barco

Dos figuras en hanfu sobre un tronco musgoso que cruza un río, bajo un pétalo rosa translúcido con rocío en el borde, con picos kársticos y cascadas que se disuelven en la bruma. Contraluz, niebla y musgo húmedo se leen como una sola luz, y los pliegues de la tela están nítidos donde cae el foco.

Una flor del tamaño de una vela de barco: Cinematic wide shot in a Chinese xianxia fantasy world, photoreal CG. A young woman in flowing pale pink and mint layered hanfu with long black hair and a jade hairpin stands on a moss-covered fallen tree trunk that bridges a shallow river, gently touching the cheek of a young swordsman in white and grey robes with a sword at his hip; both in profile, close together. Above them a giant translucent pink blossom leans over the trunk, its petals the size of sails with dewdrops on the edges and golden stamens. Behind them misty karst peaks with waterfalls, a stone arch bridge and distant pavilion roofs, peach trees in full bloom, petals drifting down onto the water. Backlit morning sun, volumetric haze, soft lens bloom, sparkle and ripples on the water in the foreground, shallow depth of field on the blossoms nearest the camera. Ethereal and romantic, with detailed fabric and wet moss textures.
Prompt

Cinematic wide shot in a Chinese xianxia fantasy world, photoreal CG. A young woman in flowing pale pink and mint layered hanfu with long black hair and a jade hairpin stands on a moss-covered fallen tree trunk that bridges a shallow river, gently touching the cheek of a young swordsman in white and grey robes with a sword at his hip; both in profile, close together. Above them a giant translucent pink blossom leans over the trunk, its petals the size of sails with dewdrops on the edges and golden stamens. Behind them misty karst peaks with waterfalls, a stone arch bridge and distant pavilion roofs, peach trees in full bloom, petals drifting down onto the water. Backlit morning sun, volumetric haze, soft lens bloom, sparkle and ripples on the water in the foreground, shallow depth of field on the blossoms nearest the camera. Ethereal and romantic, with detailed fabric and wet moss textures.

04

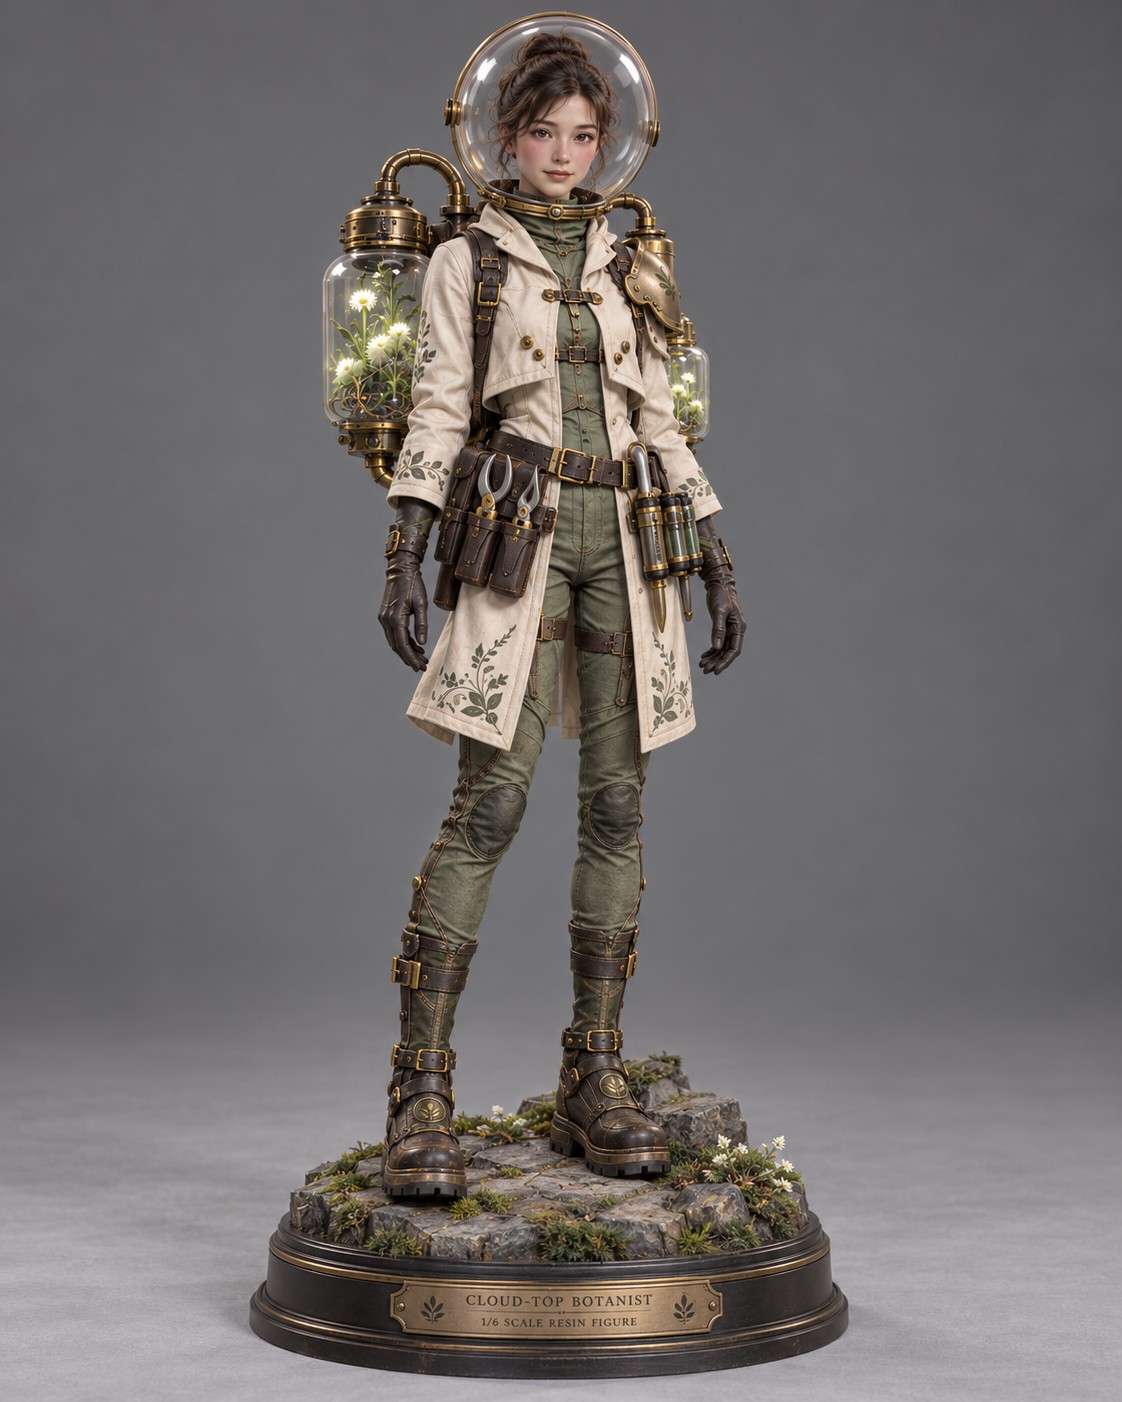
Una figura que podrías coger

Una figura a escala 1/6 de una botánica exploradora sobre su peana, casco de cristal, tanques terrario de latón y abrigo de lona bordado, fotografiada como una ficha de producto. Cristal, latón, cuero y tela conservan cada uno su acabado, y la placa dice «CLOUD-TOP BOTANIST» completo.

Una figura que podrías coger: Studio product photograph of a 1/6 scale resin collectible figure: a young woman botanist explorer standing on a rocky mossy base with tiny white wildflowers, wearing a glass dome helmet with brass fittings, a cream canvas coat with green leaf embroidery over an olive utility suit, a leather tool belt holding pruning shears and glass vials, dark leather gloves and tall buckled boots. On her back two brass and glass terrarium canisters with glowing white daisies inside. The figure stands on a round black plinth with a brass plaque reading 'CLOUD-TOP BOTANIST' and a smaller line '1/6 SCALE RESIN FIGURE'. Plain grey seamless backdrop, soft even studio light with a gentle shadow under the base, sharp focus from helmet to boots, visible material finishes: matte fabric, polished brass, clear glass, worn leather. Vertical 3:4 framing.
Prompt

Studio product photograph of a 1/6 scale resin collectible figure: a young woman botanist explorer standing on a rocky mossy base with tiny white wildflowers, wearing a glass dome helmet with brass fittings, a cream canvas coat with green leaf embroidery over an olive utility suit, a leather tool belt holding pruning shears and glass vials, dark leather gloves and tall buckled boots. On her back two brass and glass terrarium canisters with glowing white daisies inside. The figure stands on a round black plinth with a brass plaque reading 'CLOUD-TOP BOTANIST' and a smaller line '1/6 SCALE RESIN FIGURE'. Plain grey seamless backdrop, soft even studio light with a gentle shadow under the base, sharp focus from helmet to boots, visible material finishes: matte fabric, polished brass, clear glass, worn leather. Vertical 3:4 framing.

Qué puedes crear con GPT Image 2.5

Fotos de grupo en las que cada cara es una persona

Imágenes de campaña, páginas de equipo y publicaciones sociales con cinco o seis personas en el encuadre, cada una con sus rasgos y su expresión, iluminadas solo con la luz que de verdad tiene la escena.

Diseños anotados en más de un idioma

Fichas de producto, detalles constructivos y explicativos que combinan una imagen fotorrealista con anotaciones etiquetadas, donde la letra pequeña en chino y en inglés sigue siendo legible.

Escenas y productos que parecen terminados

Fotogramas cinematográficos para una presentación, o figuras de colección y envases fotografiados como una ficha de producto, donde cristal, metal, tela y piel conservan cada uno su acabado.

Para quién es GPT Image 2.5

GPT Image 2.5 es el modelo de imagen de OpenAI de septiembre de 2026, y Vidney reúne sus dos variantes en una misma página: Flare, la más rápida y la opción por defecto de OpenAI para casi todo, y Sunburst, la más lenta, pensada para ediciones precisas. Las dos funcionan de texto a imagen y de imagen a imagen, admiten hasta cuatro imágenes de referencia y cubren 1:1, 4:3, 3:4, 16:9 y 9:16 en 1K, 2K o 4K, donde 4K equivale a unos 8,3 millones de píxeles. La calidad está fijada aquí en el escalón intermedio, y los fondos transparentes, la edición con máscara y los escalones de calidad superiores siguen cerrados por ahora. Elígelo cuando las palabras dentro de la imagen tengan que salir bien a la primera.

Cómo generar imagen con GPT Image 2.5

Crea imagen con IA usando GPT Image 2.5 en Vidney en tres pasos.

Glowing panels with one model selected from severalStreams of light forming into an emerging imageA finished image materializing from a vortex of glowing light

GPT Image 2.5 vs Muse Image vs Midjourney V8.1 vs Grok Imagine Image 2.0

Especificaciones frente a modelos similares, todos disponibles en Vidney.

GPT Image 2.5Muse ImageMidjourney V8.1Grok Imagine Image 2.0
Modos de tareaTexto a imagen · Imagen a imagenTexto a imagen · Imagen a imagenTexto a imagen · Imagen a imagenTexto a imagen · Imagen a imagen
Resolución1K · 2K · 4K1K · 2K
Costo3–5 créditos por generación3 créditos por generación18 créditos por generación9–15 créditos por generación

Modelos relacionados

Más modelos de IA para generar imagen que puedes usar en Vidney.

Disponible

Genera imagen con IA usando GPT Image 2.0: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.

3 créditos por generación
Disponible

Genera imagen con IA usando GPT Image 1.5: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.

3 créditos por generación
Disponible

El modelo de imagen de Meta revisa su propio borrador antes de devolverte la imagen.

3 créditos por generación
Disponible

Genera imagen con IA usando Nano Banana 2: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.

3 créditos por generación
MidjourneyMidjourney V7
Disponible

Genera imagen con IA usando Midjourney V7: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.

6 créditos por generación
Disponible

Genera imagen con IA usando Nano Banana: texto a imagen e imagen a imagen, todo desde un solo espacio de trabajo de Vidney.

6 créditos por generación

Preguntas frecuentes

¿Qué es GPT Image 2.5?

GPT Image 2.5 es un modelo de IA para generar imagen que puedes usar en Vidney. Admite texto a imagen e imagen a imagen desde un solo espacio de trabajo.

¿Cuánto cuesta cada generación con GPT Image 2.5?

GPT Image 2.5 cuesta 3–5 créditos por generación. El costo exacto en créditos aparece en el botón de generar antes de ejecutarlo.

¿Qué relaciones de aspecto admite GPT Image 2.5?

GPT Image 2.5 admite las siguientes relaciones de aspecto: 1:1, 4:3, 3:4, 16:9, 9:16.

¿Es gratis usar GPT Image 2.5?

Sí, puedes empezar a usar GPT Image 2.5 gratis en Vidney: al registrarte recibes créditos de bienvenida, sin tarjeta y sin compromiso, para probarlo de verdad. Después, cada generación cuesta 3–5 créditos por generación, y el costo exacto siempre aparece en el botón de generar antes de gastar un solo crédito.

¿Puedo usar lo que genero con GPT Image 2.5 con fines comerciales?

Sí. Lo que generas con GPT Image 2.5 en Vidney es tuyo para usarlo en proyectos comerciales: anuncios de producto, contenido para TikTok Shop, publicaciones en redes y trabajos para clientes. Tú conservas el resultado; Vidney solo se encarga de la generación y el almacenamiento.

¿GPT Image 2.5 agrega marca de agua?

No. Lo que generas con GPT Image 2.5 en Vidney se entrega limpio, sin marca de agua de Vidney, listo para publicar o entregar a un cliente tal cual, sin pasos extra de edición.

¿Cuáles son las mejores alternativas a GPT Image 2.5?

Las alternativas a GPT Image 2.5 más cercanas en Vidney son Muse Image, Midjourney V8.1 y Grok Imagine Image 2.0. Todas funcionan en el mismo espacio de trabajo con un solo saldo de créditos, así que puedes correr el mismo prompt en cada una y comparar los resultados lado a lado.

¿Necesito una clave API o una cuenta de proveedor para usar GPT Image 2.5?

No. Vidney ejecuta GPT Image 2.5 por ti: no hay claves API que gestionar ni cuentas de proveedor que configurar.

Crea con GPT Image 2.5 ahora